Deepseek 在 2026年8月13日发布了它们的 Harness:Deepseek Harness,简称 DSH。DSH 并不是一个像 Codex、ClaudeCode 一样定制好的 Agent,它有两个显著特点:
- 开源
- 一切皆插件
这意味着 Agent 开发者可以基于 DSH 定制自己的 Agent。最近正好经常接触到一些上海小学英语学习的事情,身边也有人在学习英语,于是就想是否可以基于 DSH 打造一个私人专属的英语学习教练。我的目标是让 AI 自然地融入到用户学习英语的过程中,而不是通过一个聊天框和 AI 进行交流,所以需要对 DSH 进行全定制,包括 UI、插件、存储等各个设施。
具体到LingoLadder,首先语言学习可以划分成两个过程:能力评估和能力训练。语言能力是依靠这两个过程螺旋式上升的。基于这个认识,我们产生了业务的第一层描述:语言能力描述。
在整个实践过程中,我一直带着三个问题(视频中有比较多关于这些问题的回答,本文作为补充):
- 针对具体的业务场景,是否需要做成 Agent。
- Agent 的实现路径,具体来讲 如何通过DSH实现一个自己的Agent。这是本文第一部分和第二部分的内容。
- 顶层问题:有没有必要学习英语,再往上想 AI 必定越来越强,人应该如何学习。留待讨论的问题。
第一部分:建模
语言能力描述
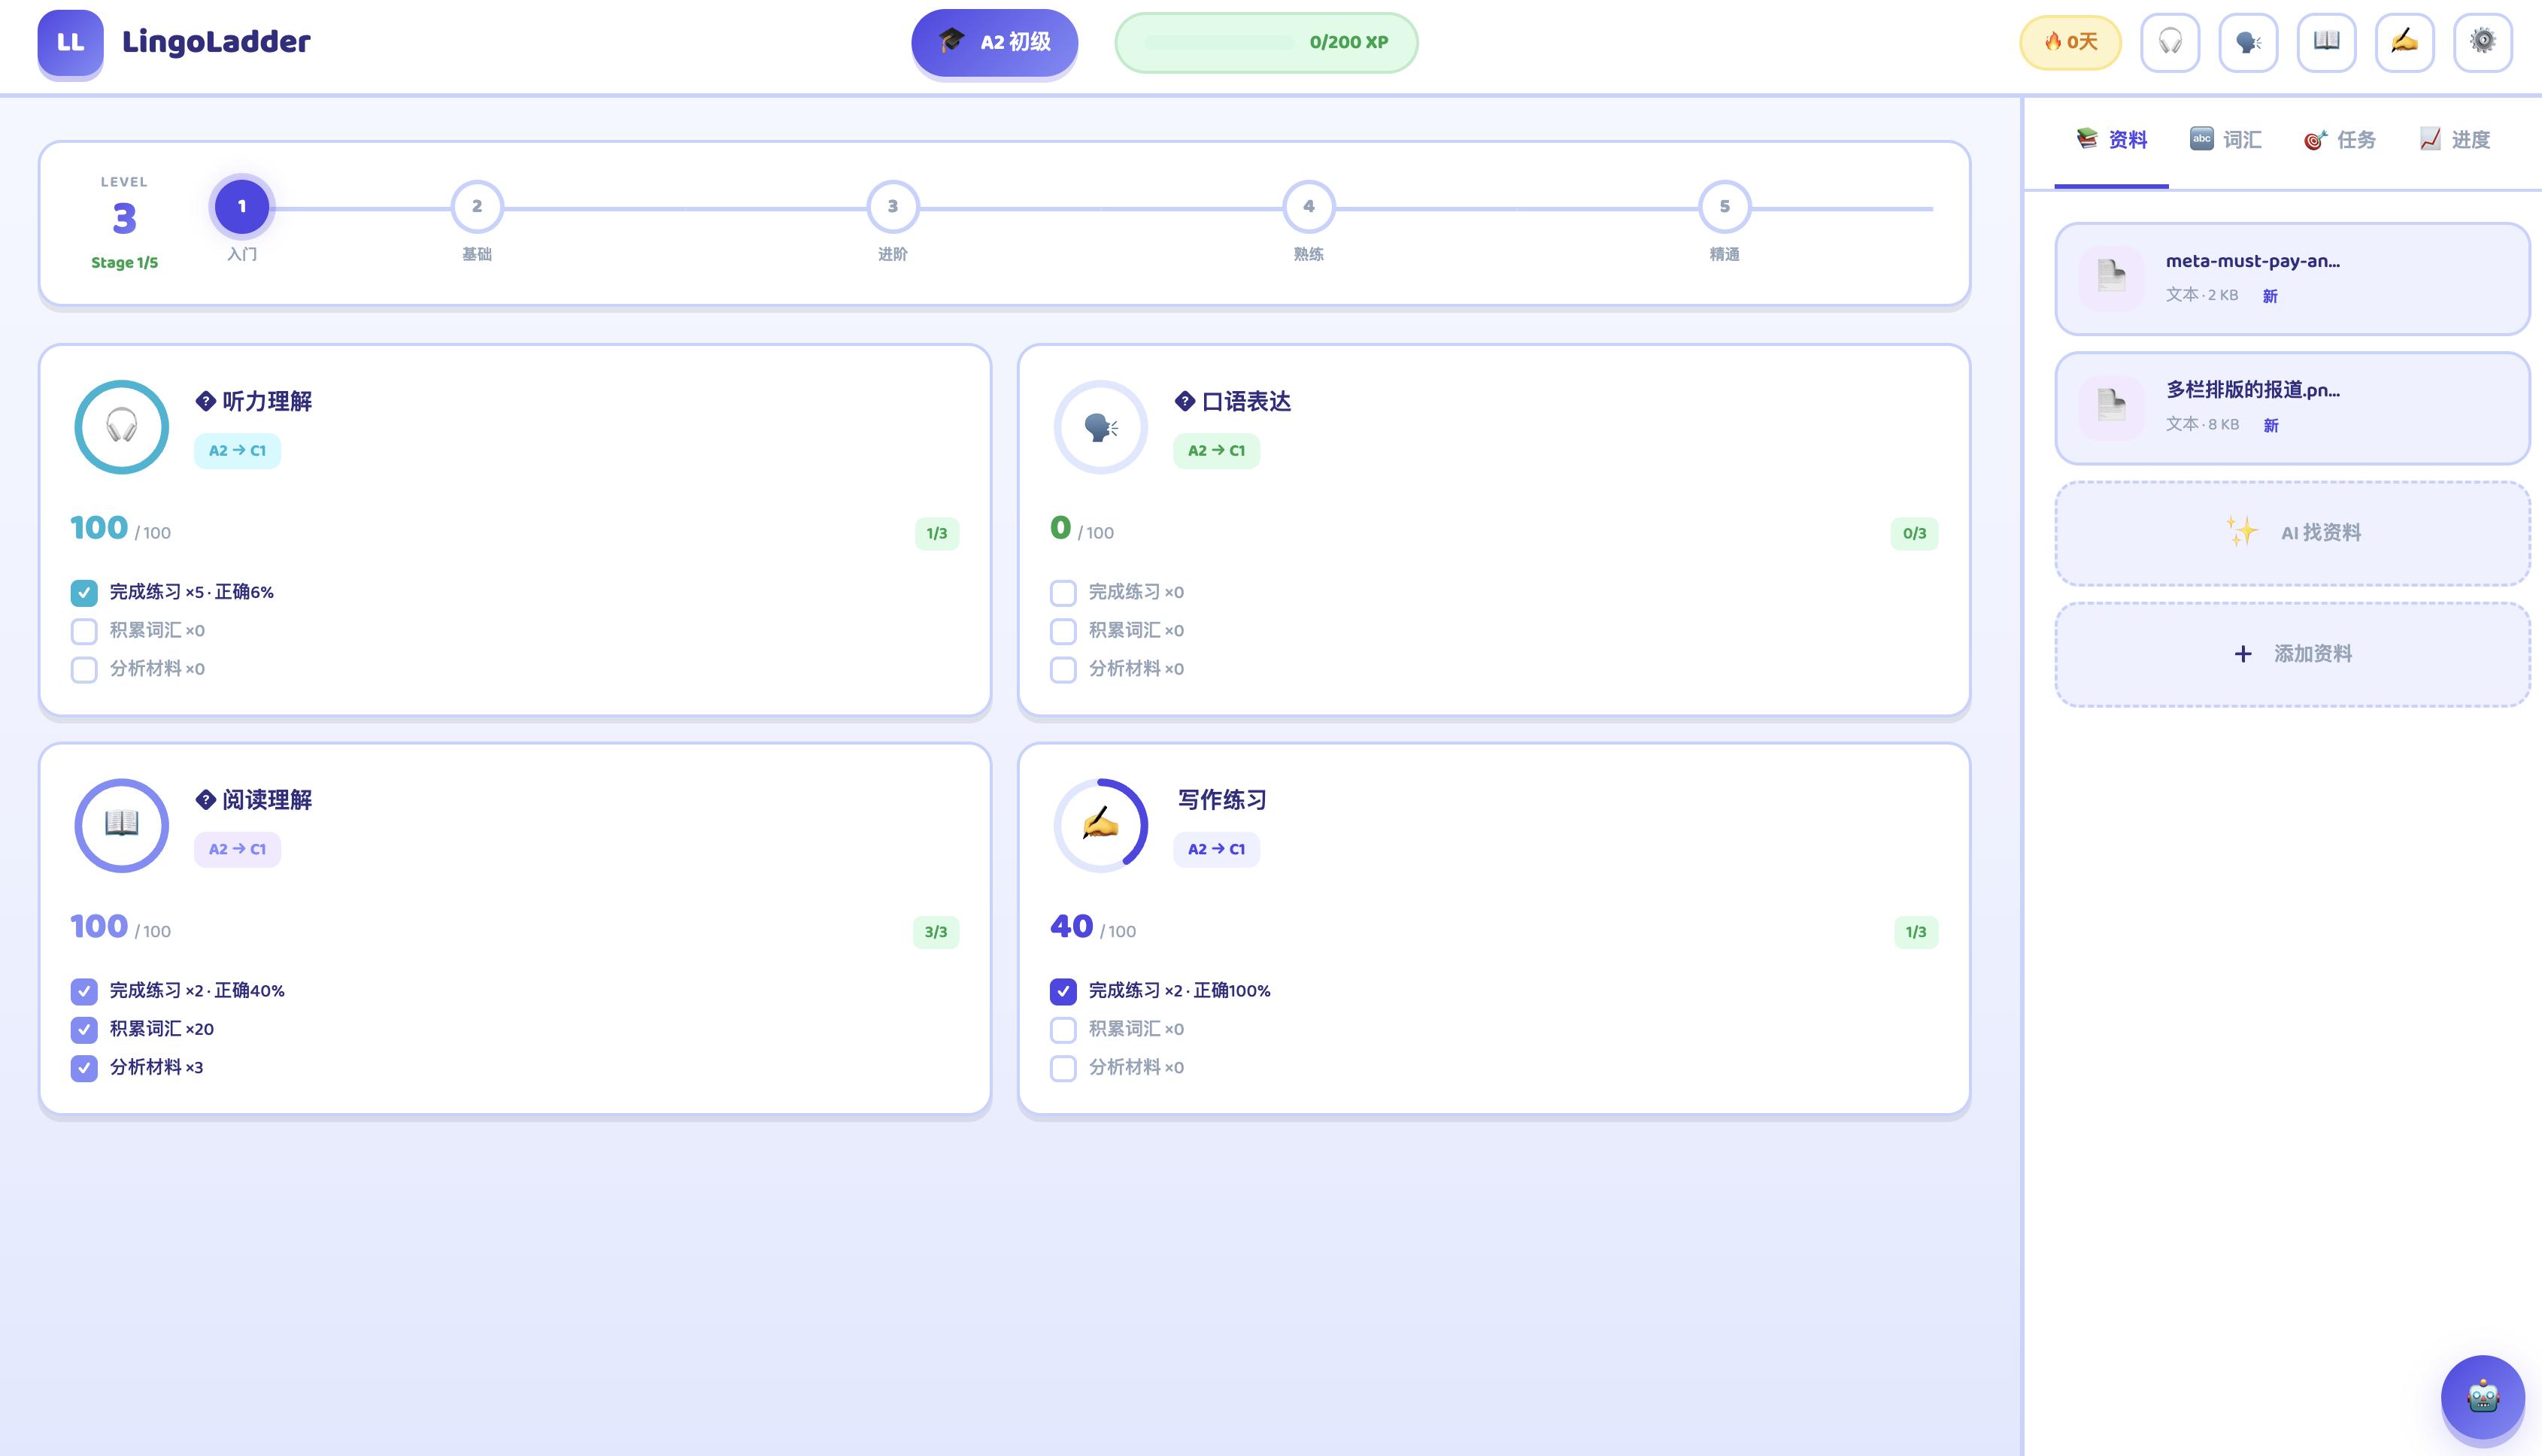
任何语言能力都分成 听、说、读、写 四个维度,在四个维度上有不同的方法表示能力水平,这里我们采用国际通用的 CEFR 语言能力描述。因此就产生了主要的交互界面,如下图所示:以能力维度为中心,可以清楚地看到每个能力维度上自己当前水平并随时进行训练。
基础设施
基于听说读写四个能力维度的评估和训练,分析需要哪些基础设施。
注意⚠️:这里先不考虑具体的实现方式,而是从概念上去思考。过早地陷入细节往往是失败的开始。
以“听”这个能力维度为例:听力是什么?它是播放一段声音材料,测试用户听了之后能否理解材料中的信息。因此需要听力材料合成能力,也就是 发声能力。所以有了第一个基础设施:AI 发声,其实也就是 tts引擎。
用同样的方式进行分析,在“说”这个维度上需要的基础设施:录音、语音识别。
在读这个维度上:需要生成文本,这是大模型天然具备的。
写:文本输入 和 文本识别,其中文本识别也是大模型天然具备的。
总结下来的基础设施有以下几部分:
- AI 发声(tts引擎)
- 录音
- 语音转文字
- 文本输入
业务的模型描述
理解了业务,抽象了基础设施后,如何用 Harness 的方式描述?
这里其实就是业务到Agent的建模,从一般到具体,我把它分成两个部分:Harness 层面 和 DSH 层面。
业务在 Harness 层面上的描述
以听力提升这个业务维度为例,Harness描述是什么样的?不论是DSH还是其他harness,从根本上讲都是在围绕上下文(或者说提示词)的设计和管理上,让 AI 能力 适应我们的场景。大概的思路是这样的:
- 通过 SystemPrompt 决定 Agent 的基础特征。
- 基于用户的交互,比如点击了听力训练,自动生成包含了当前听力能力和听力训练相关提示词。
- 上下文包含哪些工具调用,工具调用会占据上下文。
针对 LingoLadder 业务 设计上述内容,把思路告诉 Codex 等 Coding Agent,让 AI 帮我们实现即可,当然自己要能把控 AI的输出是否达到预期。
业务的 DSH 层面的描述
DSH 提供了一种非常直观的方式来帮助我们看到上下文变化的过程:轨迹视图。这对理解 DSH、制作和调试 Agent 非常有用。不仅可以预览上下文,还可以看到上下文来源。
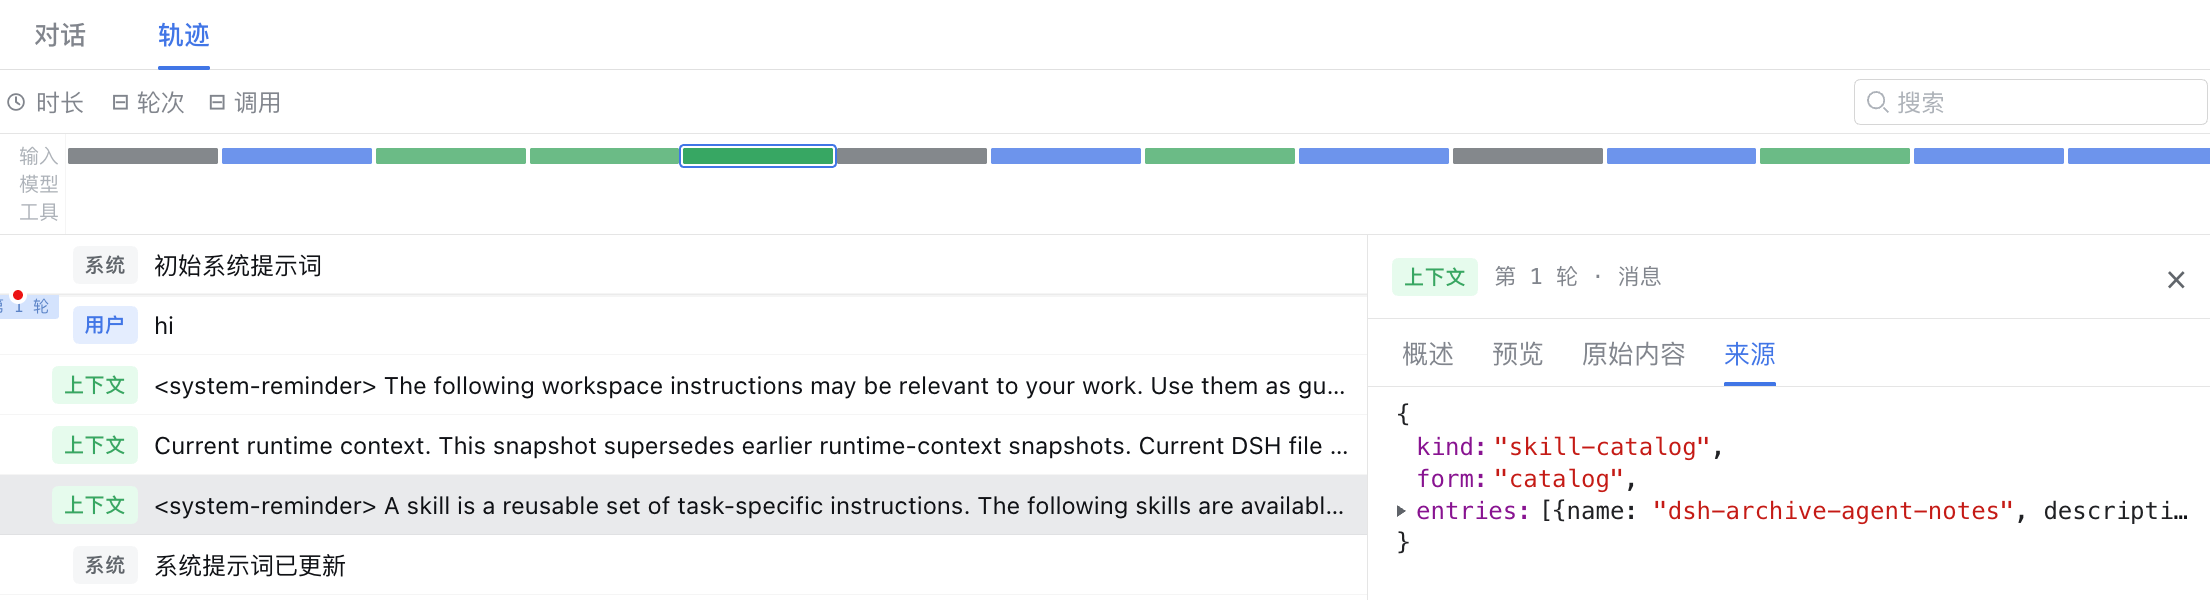
从 LingoLadder 角度分析,需要:
- 设定角色,注册自己的系统提示词。DSH 支持按作用域注册提示词。
- 先把主要能力都以 skill 方式实现,这样最简单。虽然效果未必最佳,token 消耗可能也会较高,但作为MVP是足够的。
- 持续优化:看是否能通过插件优化效果,用尽可能少的token获得尽可能佳的效果。
第二部分:实现
在开始动工前,先拿到项目源码,在 OpenCode 中通过 AI 理解项目架构和核心概念。这里不推荐古法阅读代码,因为 DSH 代码和文档本身就是 AI 生成的,古法阅读会非常难受和低效。在理解了 DSH 的主要概念后,结合英语学习 CEFR 知识进行建模,识别哪些是 agent skill,哪些是 插件、哪些是 bundle 层,哪些是核心层。
这个过程的核心原则是:兼顾能力的同时,尽可能保持核心层的简洁。
skill 层
| 技能 | 触发场景 | 核心功能 |
|---|---|---|
| material-digest | 上传资料/粘贴文本 | 难度评估、词汇提取、语法分析、摘要生成 |
| knowledge-extractor | 结构化提取 | 词汇定义、语法点、核心概念(JSON 输出) |
| exercise-generator | 请求练习/提交答案 | 交互式训练:生成→答题→批改→记录 |
| material-search | 找学习资料 | 网络搜索(Exa)、内容抓取、Markdown 保存 |
| placement-assessment | 首次使用/请求测评 | 4 轮对话式 CEFR 定级测试 |
数据存储
采用了直接的文件存储方式
.lingoladder/
  materials/          # Markdown 学习资料
  progress/           # 每次学习事件的 JSON 记录
  vocabulary/         # 词汇表(每份资料一个文件)
  profile.json        # 学习者档案(CEFR 等级、各技能水平)
  *-session.json      # 进行中的练习(临时文件)
  tts-cache/          # 缓存的合成音频
关键技术集成
LLM 提供商(DSH 内置插件)
默认 DeepSeek,支持多提供商(通过 pi-ai 适配器)
动态模型发现、API 密钥管理、路由配置
TTS(语音合成)
Microsoft Edge 神经语音(高质量):edge tts
PDF 处理
unpdf 提取文本 → 存储为 Markdown 资料
语音识别
Web Speech API 评分朗读尝试
单词重叠度算法
第三部分:我的思考
关于业务是否要做成 Agent,我在视频中做了很多的分析。这里再补充几点:
- 消失的 scale down:以前的软件是有
scale down效应的,一次开发,零成本复制。但是 Agent 不一样,它没有scale down效果,用户使用越多,token 消耗越高,成本也越高。从这个角度看,Agent 对创业是不友好的。 - 为什么腾讯、字节等公司要做 work agent?本质上是把 token经济 扩大到白领群体。
- agent = llm + harness 这个范式中的 harness 是否会一直存在?
